Issue 10006
I failure contract evitano che il retry diventi un’ipotesi
Quando un’integrazione fallisce, il punto non è solo riprovare: è sapere chi decide, cosa si ritenta e quando si ferma tutto.
· 5 min
Obiettivo
Progettare contratti di integrazione che descrivono non solo la happy path, ma anche errori, retry, compensazioni, escalation e responsabilità operative.
Cosa deve dire davvero un failure contract
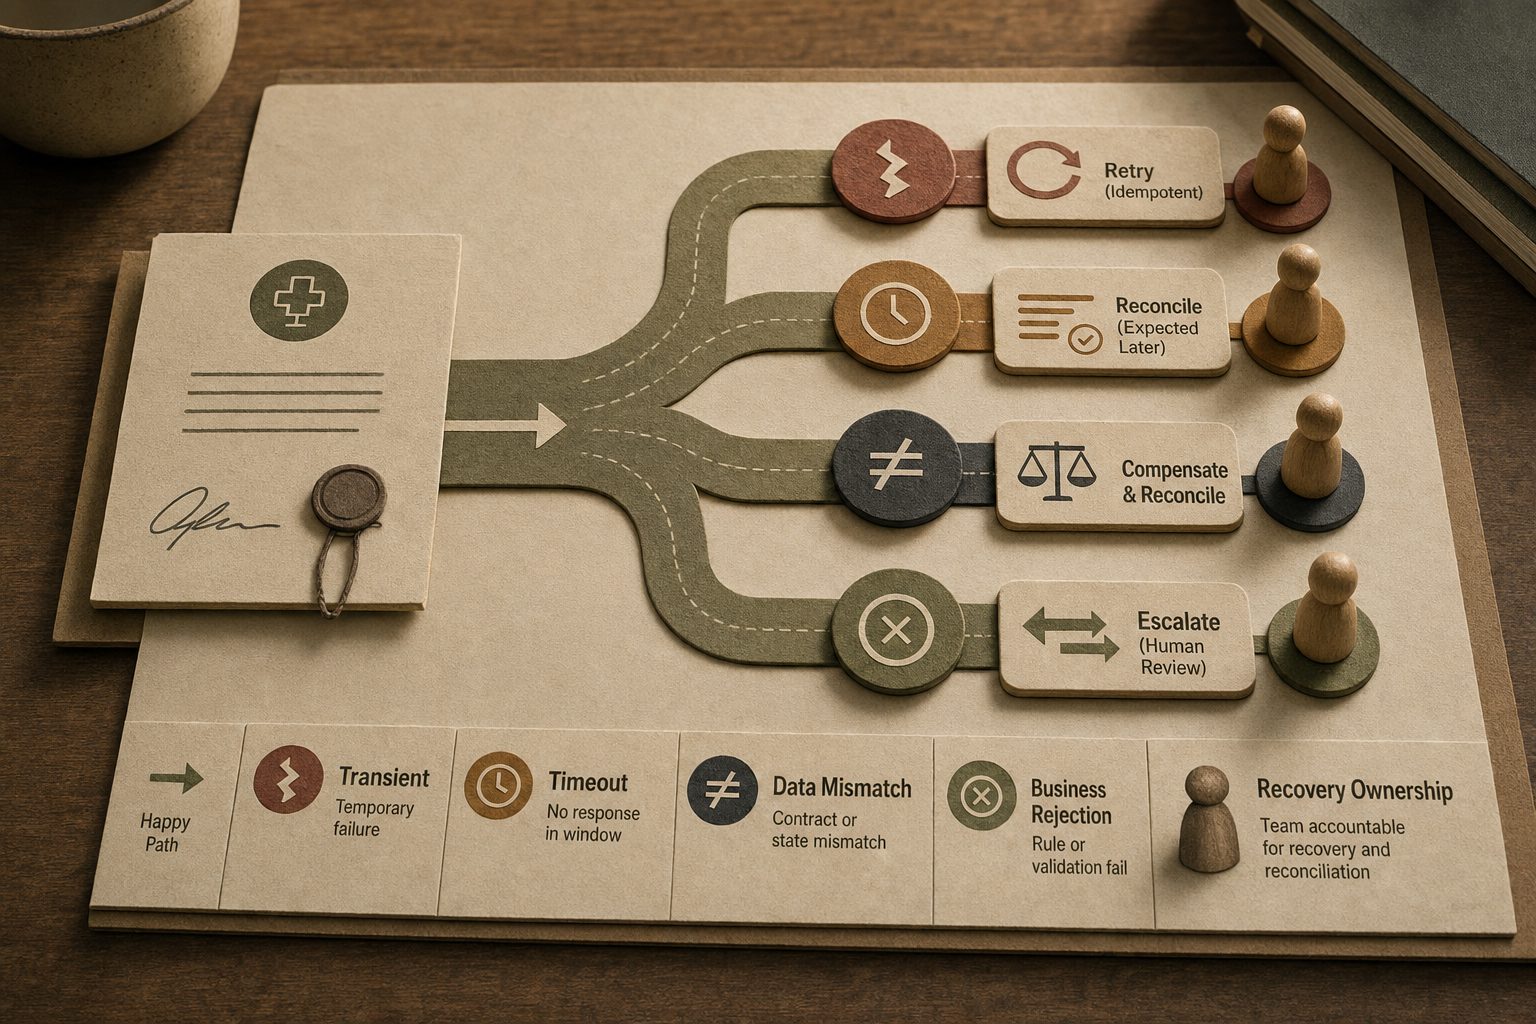
In un’integrazione enterprise non basta documentare request e response di successo. Un failure contract deve chiarire almeno quattro cose: quali errori sono temporanei e quindi ritentabili, quali sono errori di business e vanno corretti, quali casi sono ambigui e richiedono riconciliazione, e chi è responsabile dell’azione successiva. In pratica, questo significa definire timeoutGlossarioTimeoutUn limite definito a quanto un’operazione attende prima di considerare il tentativo non riuscito.Apri la voce completa, codici di errore, policy di retryGlossarioRetryUn nuovo tentativo eseguito dopo un fallimento che potrebbe essere transitorio.Apri la voce completa, idempotenzaGlossarioIdempotenzaLa proprietà per cui ripetere un’operazione non produce effetti aggiuntivi indesiderati.Apri la voce completa, compensazioni e segnali operativi. Se il provider risponde lentamente o non risponde, il contratto deve dire se il client può riprovare, quante volte, con quale backoff e con quale chiave di deduplica. Se la richiesta è stata accettata ma il processo downstream non è concluso, serve un modo chiaro per interrogare lo stato o ricevere un eventoGlossarioEventoUna dichiarazione durevole che qualcosa di significativo è già accaduto.Apri la voce completa di esito. Il valore per l’architetto è semplice: togliere ambiguità prima che diventi un problema di produzione. Un contratto che descrive anche il fallimento riduce interpretazioni locali, accelera il supporto e rende più chiara la discussione con operation e team di prodotto.
I trade-off da esplicitare subito
Il principale trade-offGlossarioTrade-offUno scambio in cui migliorare un risultato ne indebolisce o ne rende più costoso un altro.Apri la voce completa è tra semplicità dell’interfaccia e robustezza operativa. Più dettagli inserisci nel contratto, più lavoro fai all’inizio, ma meno spazio lasci a comportamenti non allineati tra team. Ci sono però compromessi reali da valutare: - Retry automatici migliorano la resilienzaGlossarioResilienzaLa capacità di continuare a produrre risultati utili quando componenti falliscono o le condizioni degradano.Apri la voce completa, ma possono amplificare il carico o duplicare effetti se manca idempotenza. - Una risposta sincrona è più facile da capire, ma può nascondere processi lunghi o stati intermedi. - Le compensazioni chiudono bene il ciclo, ma richiedono responsabilità chiare e spesso logiche aggiuntive nei sistemi coinvolti. - Esporre molti dettagli di errore aiuta l’operatività, ma può aumentare la complessità per i consumer e rendere più fragile il contratto. Il punto non è evitare i failure contract per restare “agili”. È scegliere consapevolmente dove vuoi assorbire la complessità: nel contratto, nell’orchestrazione o nel lavoro manuale del supporto. Se non la decidi, la complessità si sposta comunque, solo in modo meno controllato.
Esempio enterprise: ordine accettato ma non completato
Immagina un e-commerce che invia un ordine all’OMS. L’OMS risponde 202 Accepted, quindi il team applicativo interpreta il messaggio come successo. Però la riserva di stock fallisce dopo qualche minuto per indisponibilità di inventario in un magazzino secondario. Senza failure contract, succede quasi sempre questo: il front-end mostra ordine creato, il customer care non sa dove controllare lo stato, il team integrazione non sa se ritentare e il canaleGlossarioCanaleUn formato o una destinazione attraverso cui una issue raggiunge il lettore.Apri la voce completa commerciale chiede una risposta coerente che nessuno può dare con sicurezza. Con un failure contract, invece, i punti critici sono espliciti: dove leggere lo stato dell’ordine, quale evento segnala il fallimento asincrono, se il retry è automatico o manuale, quando aprire un alert e quale sistema è owner della riconciliazione. In questo scenarioGlossarioScenarioUna situazione concreta usata per testare come un design o una decisione si comporta.Apri la voce completa il 202 non viene più letto come successo definitivo, ma come accettazione della presa in carico. È una differenza piccola nel codice, ma enorme per l’operatività.
Per approfondire
Fonti autorevoli per approfondire error handling, resilienza e contratti di integrazione. • Designing Data-Intensive Applications - Martin Kleppmann - https://dataintensive.net/ • Microservices Patterns - Chris Richardson - https://microservices.io/patterns/ • RFC 9110: HTTP Semantics - IETF - https://www.rfc-editor.org/rfc/rfc9110.html