Issue 10046
Progetta i guardrail, non prompt più dettagliati
L’autonomia degli agenti diventa affidabile quando limiti l’autorità tecnica, non quando speri in istruzioni più dettagliate.
· 5 min
Dalla serie
Obiettivo
Tradurre i limiti di autonomia degli agenti in controlli tecnici applicabili: permessi minimi, isolamento, fail-closed, operazioni reversibili e autorizzazioni esplicite.
Dal prompt all’architettura dei guardrail
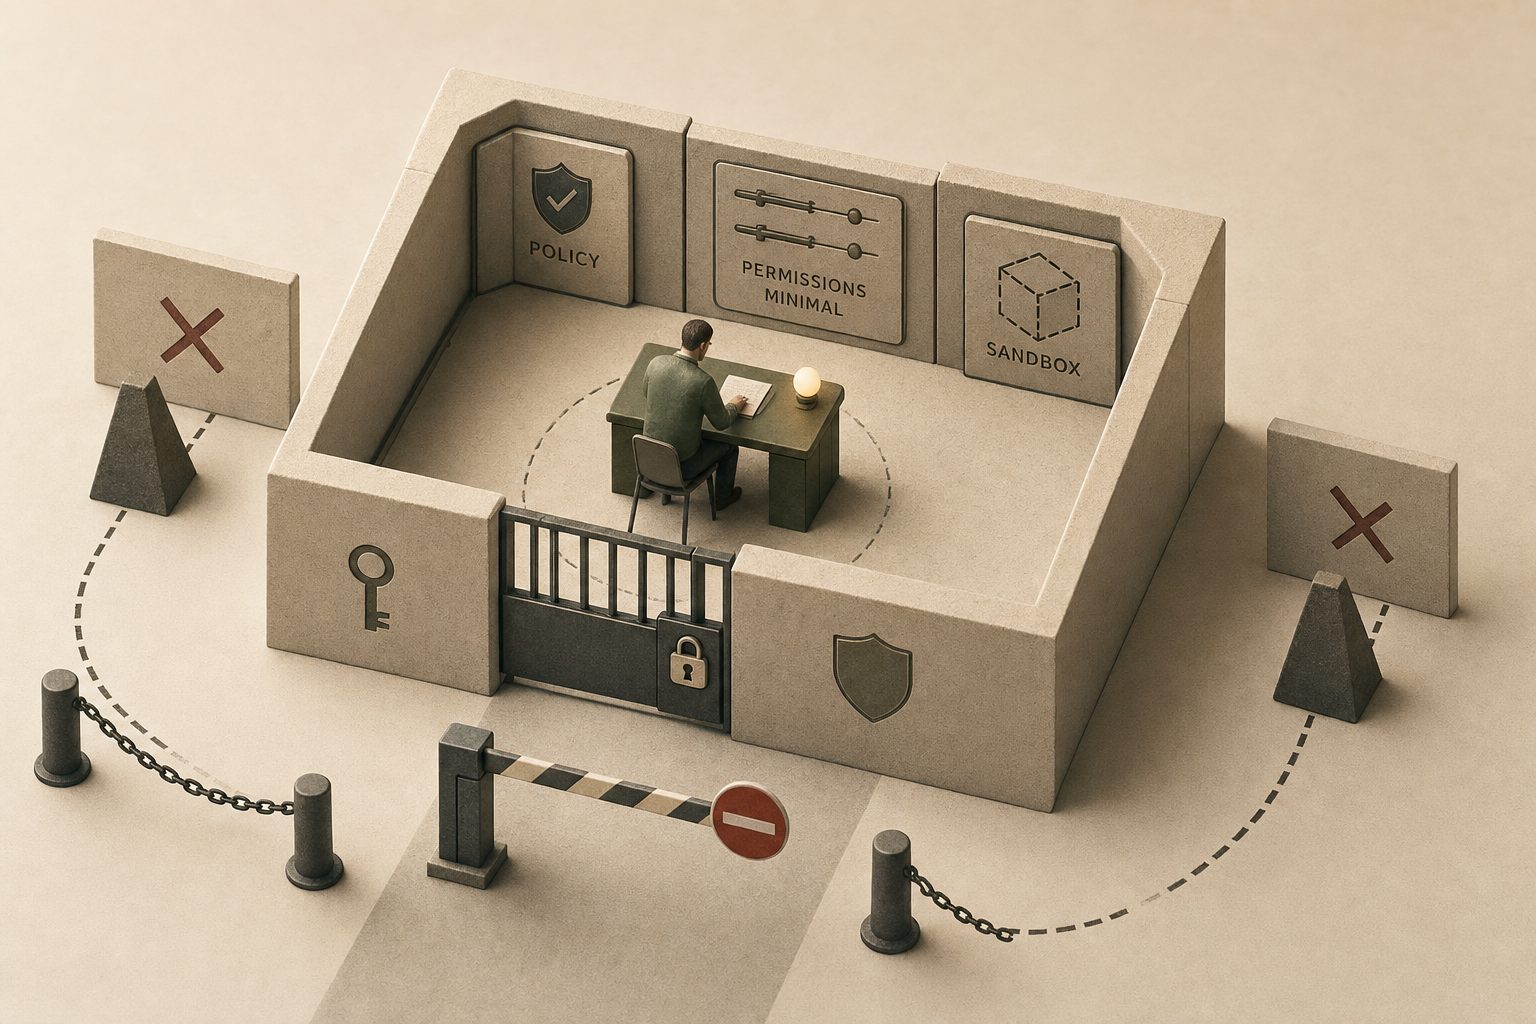
Se vuoi delegare lavoro a un agente, il punto non è scrivere un prompt più lungo. Il punto è definire quali azioni può compiere davvero, su quali ambienti, con quali dati e con quale raggio d’impatto. In pratica, l’autonomia utile nasce da quattro scelte architetturali: accesso minimo agli strumenti, isolamento dell’esecuzione, verifiche prima delle modifiche e blocco esplicito quando manca un requisito. Un buon testGlossarioTestUna verifica deliberata che produce evidenze su una specifica aspettativa o rischio.Apri la voce completa è semplice: se l’agente sbaglia o interpreta male il contesto, quanto può danneggiare il sistema? Se la risposta è “molto”, non hai un problema di prompt. Hai un problema di autorità non confinata. Per renderlo operativo, separa sempre lettura e scrittura. Identifica prima il target in sola lettura, poi consenti la mutazione solo sul target verificato. Usa ambienti temporanei o sandbox per le attività esplorative. Richiedi un’autorizzazione umana esplicita per produzione, operazioni distruttive, integrazioni esterne e cambiamenti irreversibili. Ma non confondere l’approvazione con il controllo: il gate umano decide se procedere, mentre permessi, isolamento e motori di policy devono impedire tecnicamente le azioni fuori perimetro. Se identità, policy o prerequisiti non sono verificabili, l’agente deve fermarsi e restituire il blocco, non improvvisare.
Trade-off da dichiarare subito
I guardrail riducono la libertà apparente, ma aumentano la qualità della delega. Il guadagno principale è chiaro: il massimo danno possibile resta limitato dall’ambiente, non dalla “buona volontà” del modello. Questo rende più semplice governare l’uso dell’agente con sicurezza, operations e gestione del rischio. Il costo è altrettanto reale: più controlli significano più passaggi, maggiore integrazione con IAM e motori di policy e un po’ meno velocità nelle attività banali. Ma è un trade-offGlossarioTrade-offUno scambio in cui migliorare un risultato ne indebolisce o ne rende più costoso un altro.Apri la voce completa sano. Se un agente può agire ovunque, troppo in fretta e senza conferme, stai ottimizzando la demo, non il sistema. C’è anche un effetto organizzativo: i guardrail rendono più esplicite le responsabilità. Chi possiede il workflow deve chiarire dove finisce l’automazione, dove serve un’autorizzazione umana e quali limiti devono essere applicati tecnicamente. È spesso lì che emergono i veri confini di rischio.
Esempio enterprise realistico
In una grande azienda, un team vuole usare un delivery agent per preparare modifiche a una pipeline CI/CD e aggiornare configurazioni applicative. All’inizio l’idea sembra semplice: “basta spiegargli bene cosa fare”. Ma il team scopre presto che il problema non è la comprensione del compito: è il perimetro di azione. La soluzione diventa più robusta quando il processo viene diviso così: l’agente può leggere repository, issueGlossarioIssueUna lezione di Architecture Coffee rappresentata come canonical Issue Content e portata attraverso review e pubblicazione.Apri la voce completa e manifest; può proporre una patch in un ambiente isolato; può eseguire test e raccogliere evidenze; non può eseguire il merge né distribuire in produzione, aprire connessioni esterne non necessarie o modificare risorse fuori ambito. Per passare dalla proposta al rilascio serve la conferma esplicita di una persona autorizzata, ma anche dopo quella conferma i controlli tecnici continuano ad applicare il perimetro consentito. Il risultato non è un agente “più intelligente”. È un sistema più affidabile, perché il comportamento rischioso è tecnicamente impossibile o fortemente vincolato.
Per approfondire
Fonti autorevoli per approfondire autorità limitata, privilegi minimi, sicurezza agentica e controlli fail-closed. • Agentic AI — Threats and Mitigations - OWASP GenAI Security Project - https://genai.owasp.org/resource/agentic-ai-threats-and-mitigations/ • LLM06:2025 Excessive Agency - OWASP GenAI Security Project - https://genai.owasp.org/llmrisk/llm06-sensitive-information-disclosure/ • NIST SP 800-207: Zero Trust Architecture - NIST - https://csrc.nist.gov/pubs/sp/800/207/final